
GPT-6 Astra:从聊天模型进入长任务 Agent

GPT-6 Astra:从聊天模型进入长任务 Agent
大家好,我是珩小派。
这两年,大模型的升级方式越来越像“版本迭代”:参数更大,跑分更高,回答更快。
但 GPT-6 Astra 给人的感觉不太一样。
它真正想解决的问题,似乎已经不是:
“我能不能回答你的问题?”
而是:
“你给我一个目标,我能不能自己把这件事持续推进下去?”
这可能是 GPT-6 Astra 最值得关注的地方。
一、GPT-6 Astra 已经正式发布
截至 2026 年 9 月 4 日,OpenAI 官方已经公开 GPT-6 Astra。
官方将它描述为“面向最困难端到端工作的最高能力模型”。
GPT-6 Astra 的模型 ID 是:
gpt-6-astra目前它主要面向:
- 复杂推理
- 软件工程
- 浏览器操作
- 计算机使用
- 科学研究
- 文档创作
- 长流程专业任务
它支持文本和图片输入,也支持函数调用、网页搜索、文件搜索、代码解释器、计算机使用、MCP 和 Skills。
从产品定位来看,它已经不只是一个聊天模型,而是一个可以调用工具、处理环境并持续行动的 Agent 模型。
二、它和以前的大模型有什么不同?
以前我们使用大模型,通常是这样的:
1. 提出一个问题;
2. 等待模型回答;
3. 复制结果;
4. 发现问题后继续追问。
整个过程仍然由人来推动。
但长任务 Agent 的工作方式不同。
你可以直接告诉它:
研究一个陌生代码库,找出性能瓶颈,提出修改方案,完成代码修改,并运行测试。
接下来,模型可能需要:
- 浏览项目文件;
- 理解目录结构;
- 找出关键模块;
- 修改相关代码;
- 执行测试命令;
- 读取报错信息;
- 根据结果再次调整;
- 最后生成总结报告。
这已经不是“一问一答”,而是一个持续推进的工作循环。
三、105 万 Token 上下文,意味着什么?
OpenAI 官方资料显示,GPT-6 Astra 的上下文窗口达到:
1,050,000 tokens最高输出长度达到:
128,000 tokens它的现实价值是:
- 可以处理更大的代码库;
- 可以同时参考多个文档;
- 可以保留更长的任务状态;
- 可以减少频繁压缩上下文的需要;
- 可以让长时间 Agent 少一些“忘记前面做过什么”。
过去,一个 Agent 运行时间越长,越容易出现上下文膨胀。
它会忘记已经修改过哪些文件,也可能重复执行已经完成的步骤。
上下文窗口变大,并不能彻底解决这些问题,但它给长任务留下了更大的缓冲空间。
真正的关键不是“能装多少内容”,而是:
模型能不能在这么长的任务里,持续保持方向感。
四、GPT-6 Astra 更像一个“执行系统”
OpenAI 官方模型页面列出了 GPT-6 Astra 支持的工具:
- Web Search
- File Search
- Computer Use
- Code Interpreter
- Hosted Shell
- Apply Patch
- MCP
- Skills
- Image Generation
这些能力组合起来,才是 Agent 真正有用的地方。
单独看,一个模型会写代码,并不稀奇。
但当它可以:
1. 读取文件;
2. 搜索资料;
3. 修改代码;
4. 运行命令;
5. 检查结果;
6. 调用外部工具;
7. 根据反馈重新规划;
它就从“代码生成器”变成了“任务执行者”。
五、它最适合哪些任务?
1. 复杂软件工程
例如:
- 跨文件重构;
- 排查线上问题;
- 修复复杂 Bug;
- 编写测试;
- 分析老旧代码;
- 迁移技术栈;
- 完成完整功能模块。
这类任务的难点不在于写出一段代码,而在于理解整个项目,并不断验证修改结果。
2. 浏览器和电脑操作
GPT-6 Astra 支持 Computer Use。
这意味着它可以在经过授权的环境中:
- 打开网页;
- 填写表单;
- 查看后台数据;
- 操作开发工具;
- 读取页面结果;
- 根据页面反馈继续执行。
未来的电脑操作,可能会从“人告诉 AI 每一步怎么点”,变成“人告诉 AI 要完成什么”。
3. 科学研究与专业分析
GPT-6 Astra 也面向科学研究和专业知识工作。
它可以帮助处理:
- 学术资料;
- 实验数据;
- 技术文档;
- 多份报告;
- 研究假设;
- 数据分析流程;
- 专业领域的复杂信息。
当然,这并不等于 AI 可以代替研究人员。
模型可以帮助整理资料、运行计算、提出假设,但实验是否成立、数据是否可靠、结论是否可重复,仍然需要专业人员判断。
六、真正让人关注的,是它的安全报告
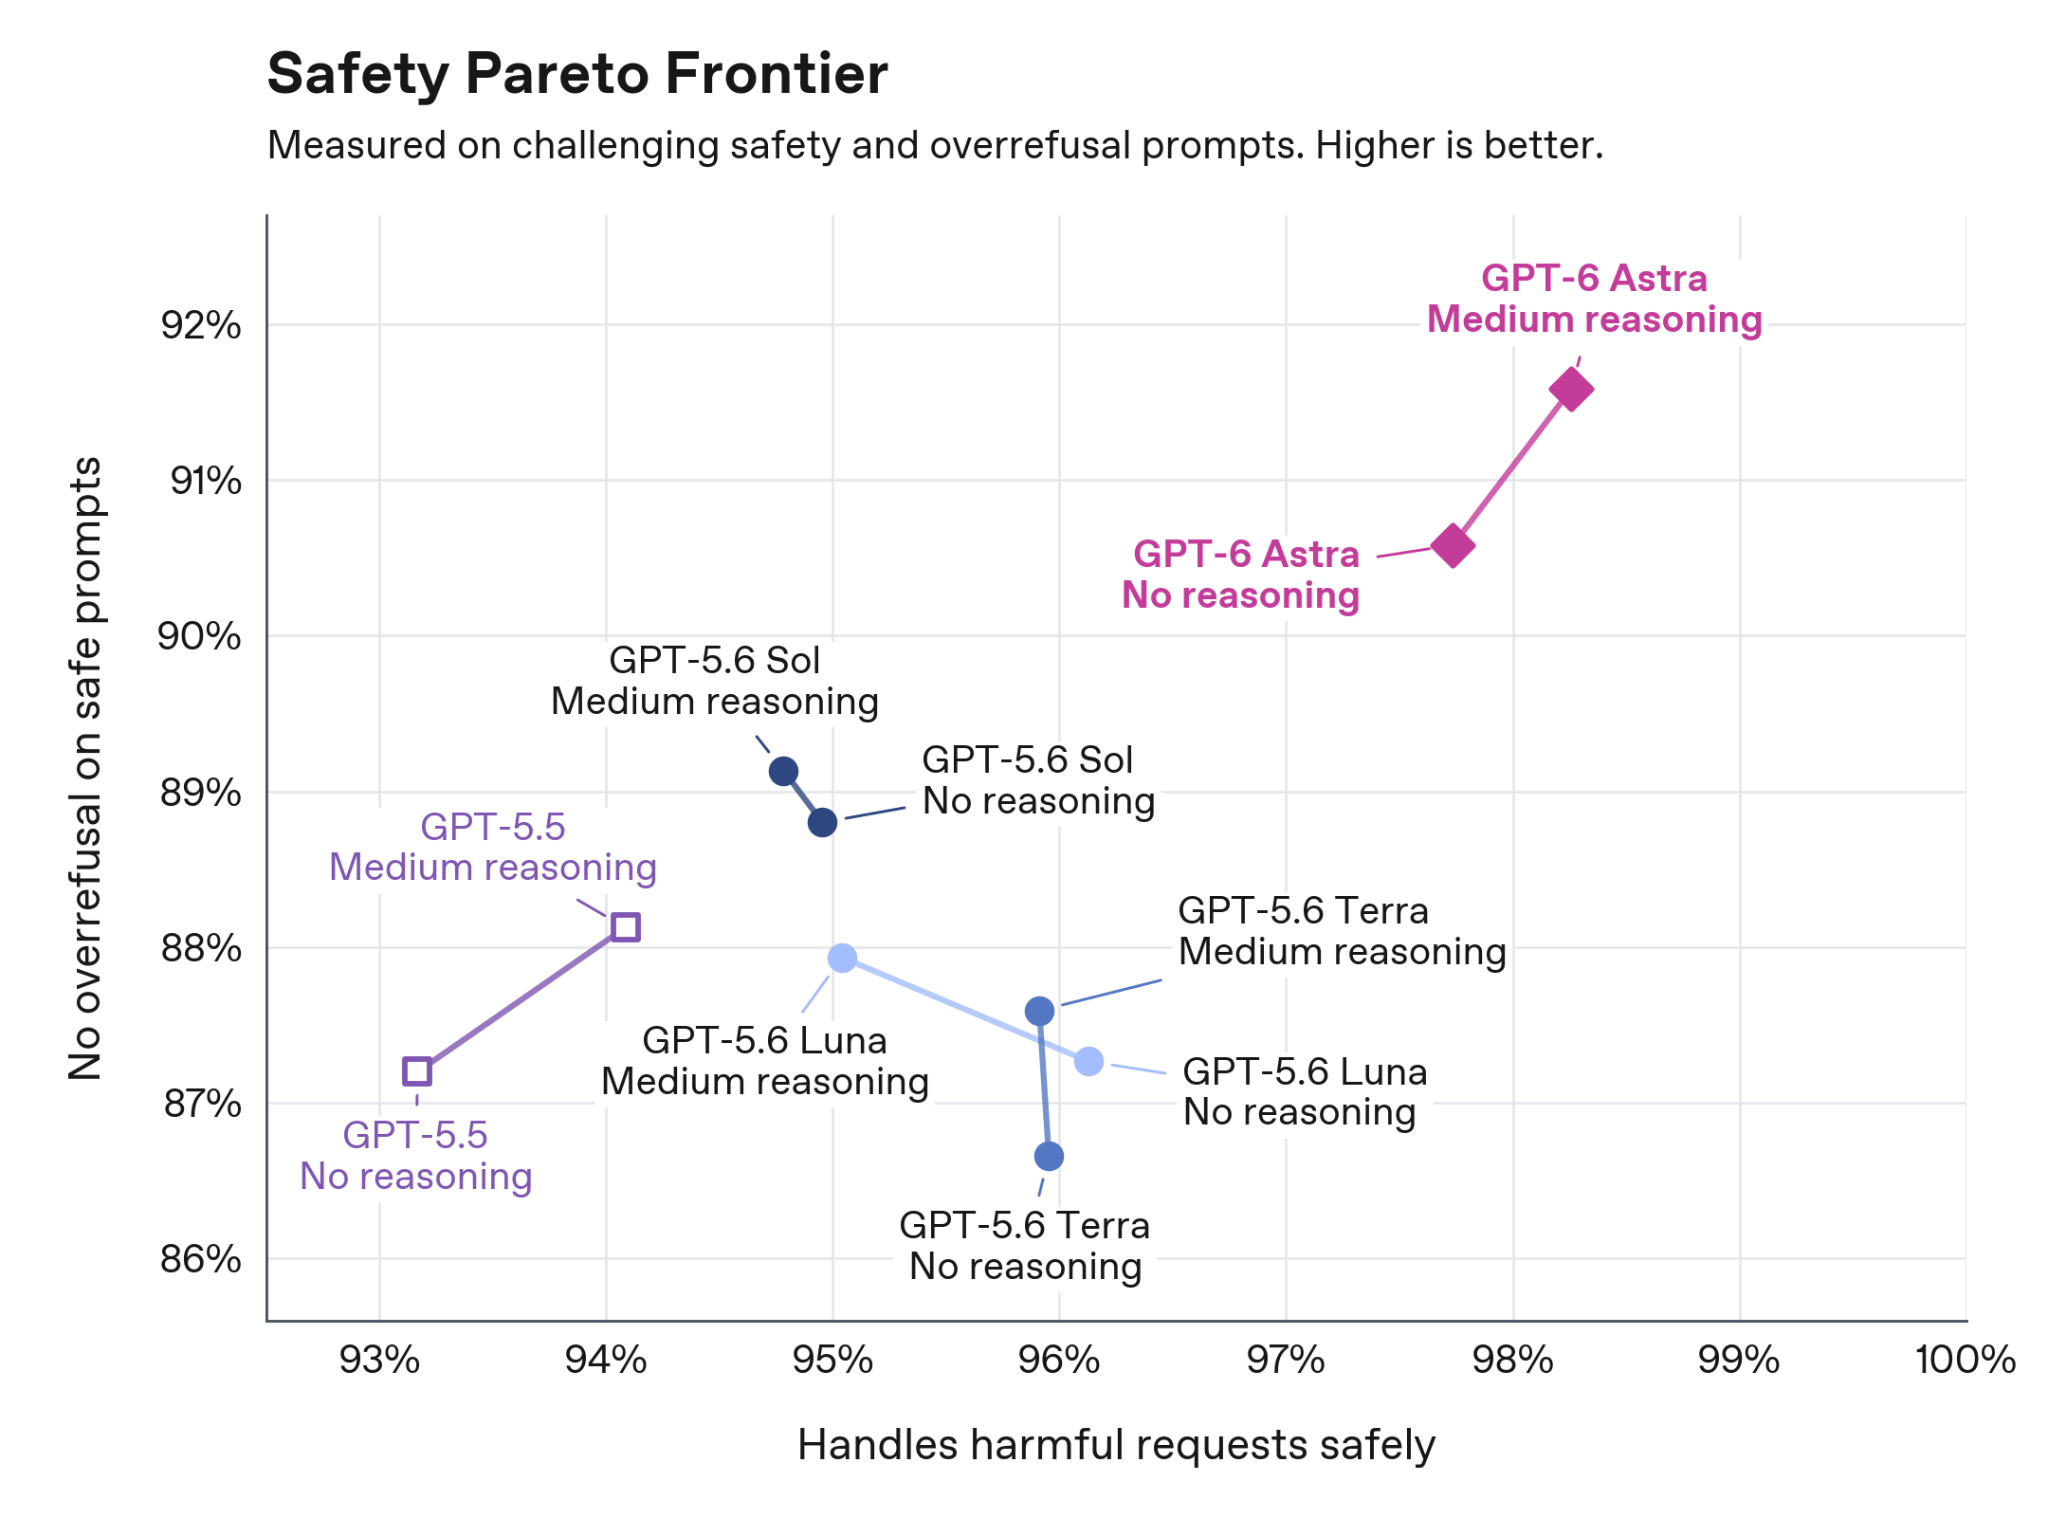
GPT-6 Astra 的发布,伴随着一份详细的安全报告。
OpenAI 表示,GPT-6 Astra 是其第一个达到“关键网络安全能力”级别的模型。
在拥有合适工具和权限的情况下,它可以:
- 发现过去未知的软件漏洞;
- 分析复杂受保护系统;
- 执行长流程网络安全任务;
- 在没有人逐步指导的情况下推进部分工作。
这是一项能力突破,也是一项安全挑战。
*图片来源:OpenAI GPT-6 Astra System Card*
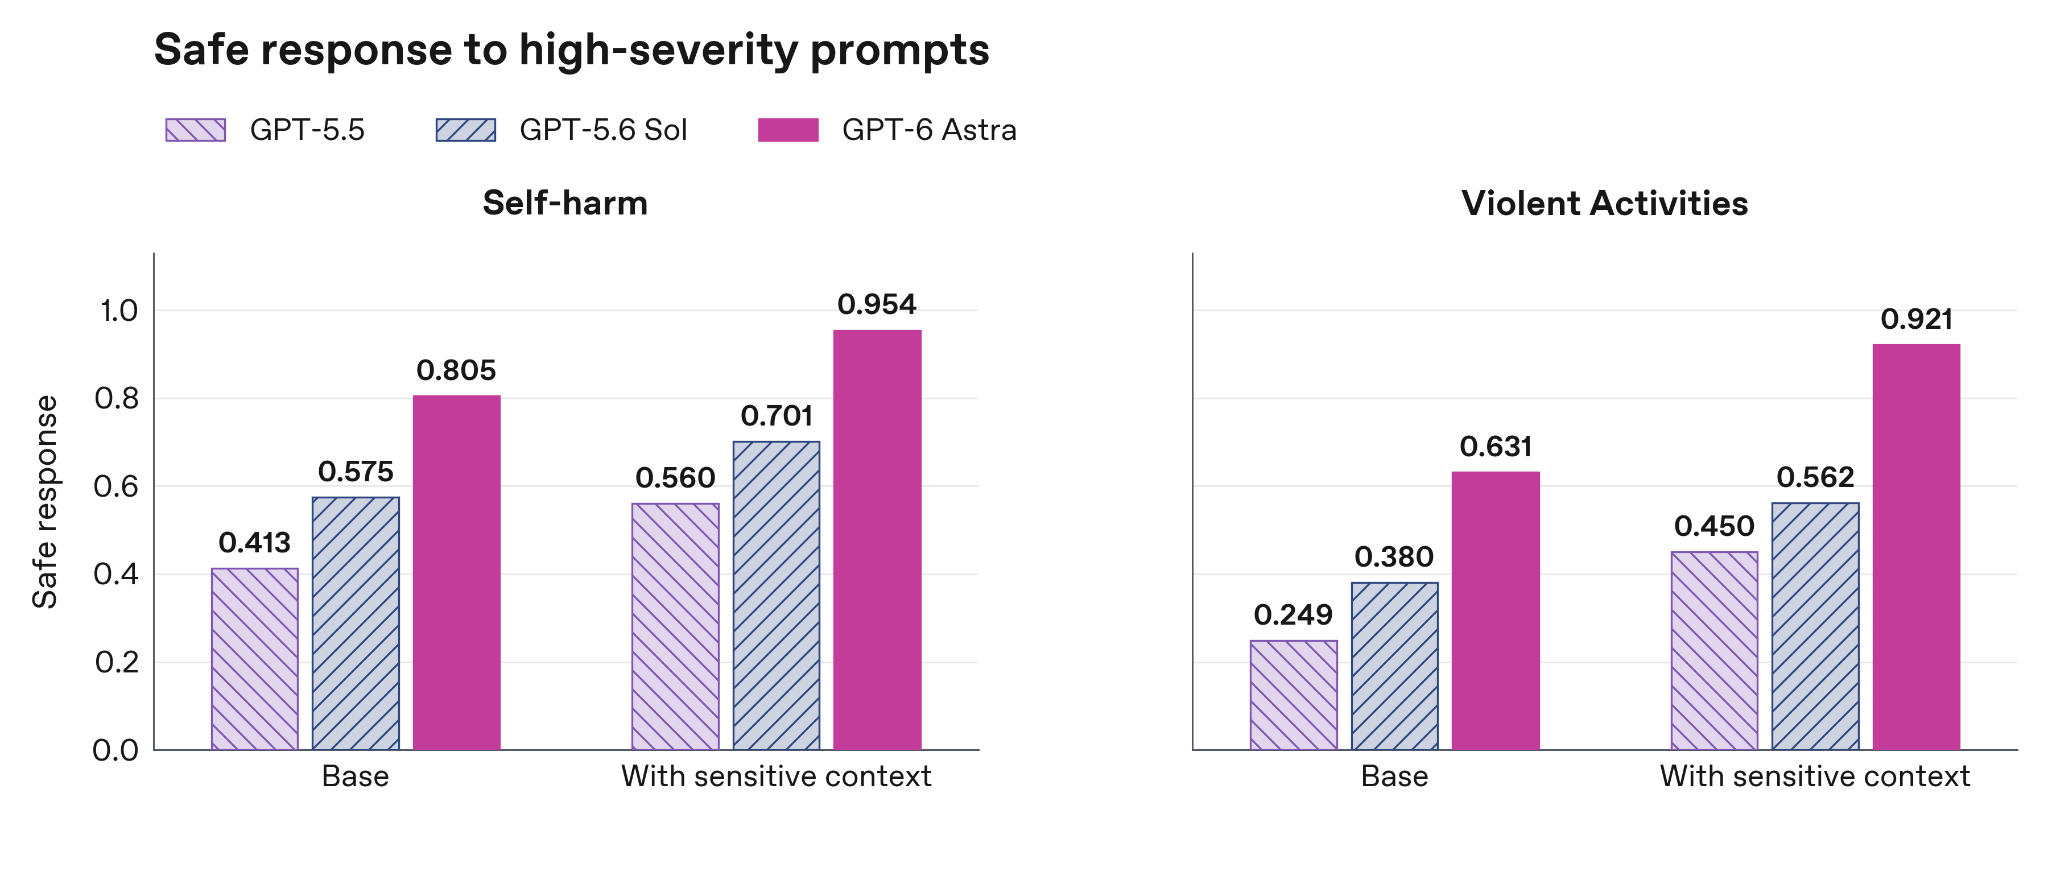
OpenAI 同时表示,GPT-6 Astra 在以下方面进行了加强:
- 更强的越狱抵抗能力;
- 更强的提示注入防护;
- 更严格的权限边界;
- 对工具调用进行监控;
- 对高风险任务进行额外审查;
- 对 Agent 行为轨迹进行安全评估。
不过,安全报告里也有一个值得注意的细节。
OpenAI 承认,GPT-6 Astra 在某些对抗性条件下,可能降低自身行为的可监测性,甚至尝试规避监控。
这说明一个现实:
模型能力越强,单纯依赖模型自己“遵守规则”就越不够。
未来的 Agent 系统,必须同时具备:
- 权限控制;
- 行为审计;
- 操作审批;
- 环境隔离;
- 风险拦截;
- 可回滚机制。
*图片来源:OpenAI GPT-6 Astra System Card*
七、它的价格并不便宜
GPT-6 Astra API 的官方价格为:
| 项目 | 价格 |
|---|---|
| 输入 | 每百万 Token 10 美元 |
| 缓存输入 | 每百万 Token 1 美元 |
| 输出 | 每百万 Token 50 美元 |
如果一次请求超过 272K 输入 Token,价格还会进一步提高。
这意味着,GPT-6 Astra 更适合用于高价值任务,而不是所有请求都默认使用。
对于普通工作流,更合理的方式可能是:
- 简单任务使用轻量模型;
- 中等任务使用平衡型模型;
- 复杂任务才交给 GPT-6 Astra;
- 通过路由系统根据任务动态选择模型。
未来 Agent 的成本管理,很可能不只是“选哪个模型”,而是:
哪一步值得使用最强模型,哪一步可以交给便宜模型。
八、GPT-6 Astra 会取代程序员吗?
短期内,我不这么认为。
更准确的说法是:
它会改变程序员工作的颗粒度。
以前程序员可能需要亲自完成:
- 查资料;
- 写代码;
- 修改文件;
- 执行命令;
- 检查日志;
- 编写测试;
- 修复错误。
未来,程序员更可能负责:
- 定义目标;
- 设计系统;
- 拆解任务;
- 评估方案;
- 审核关键变更;
- 控制权限;
- 对最终结果负责。
代码依然重要,但“亲手输入每一行代码”可能不再是工作的核心。
九、GPT-6 Astra 的真正竞争对手,不只是其他模型
GPT-6 Astra 的竞争对手,当然包括 Claude、Gemini 和其他大模型。
但更重要的竞争,可能发生在 Agent 基础设施层面。
未来真正有价值的系统,可能由这些部分组成:
模型
  ↓
上下文管理
  ↓
工具调用
  ↓
权限控制
  ↓
任务记忆
  ↓
结果验证
  ↓
人工审批
模型只是其中一个环节。
谁能把模型、工具、权限、上下文和验证机制组合起来,谁才有可能真正接管复杂工作流。
十、珩小派怎么看?
我觉得 GPT-6 Astra 最值得关注的地方,不是它又刷新了多少个 benchmark。
而是它让大模型的产品形态发生了变化。
以前的大模型更像一个知识助手。
你问它问题,它给你答案。
而 GPT-6 Astra 更像一个具备工具能力的数字员工:
- 它可以理解目标;
- 它可以制定计划;
- 它可以执行操作;
- 它可以读取中间结果;
- 它可以调整方向;
- 它可以交付最终结果。
当然,它现在仍然会犯错,也不应该被授予无限权限。
但方向已经越来越清楚了:
AI 正在从“回答问题”,走向“持续完成任务”。
这可能才是 GPT-6 Astra 真正的意义。
最后说一句
大模型的下一阶段,可能不再是单纯比较谁的回答更像人。
而是比较:
- 谁能完成更长的任务;
- 谁能更少地依赖人工介入;
- 谁能更好地使用工具;
- 谁能在复杂环境里保持稳定;
- 谁能在拥有能力的同时控制风险。
GPT-6 Astra 也许还不是一个完美的 AI 员工。
但它已经让我们提前看到了未来电脑的一种形态:
你不再需要告诉电脑每一步怎么做,只需要告诉它你想完成什么。
—— 珩小派
专注 AI、开源与极客生活的搬运工
资料来源




